大模型部署调用(vLLM+LangChain)
大模型应用框架

一般来说,大模型应用的整体结构可以划分为几个层次:
-
• 模型层:
-
• 功能:负责处理输入数据并生成输出。
-
• 代表:BERT、GPT、Qwen2等等
-
• 推理层:
-
• 功能:将大模型部署到服务端,暴露API。(行业普遍规范是OpenAI compatible API)
-
• 代表:vLLM
-
• API层:
-
• 功能:将语言模型与其他数据源、API 和服务集成,方便上层应用开发。
-
• 代表:LangChain
-
• 应用层:
-
• 功能:医疗、教育、金融、法律等垂类应用的具体支撑系统
基于以上的层次信息,我们接下来初步了解行业目前普遍使用的:vLLM + LangChain。
vLLM
简介: vLLM 是一个专为大语言模型(LLMs)设计的高效推理库,旨在优化推理速度和内存使用。它通过动态计算图和先进的内存管理技术,帮助开发者在资源有限的情况下高效地运行大型模型。vLLM 支持多种流行的语言模型,使得用户能够快速切换和比较不同的模型,适用于实时应用场景。
网址:https://docs.vllm.ai/en/latest/index.html
作用:
-
• 把大模型部署到服务端,暴露OpenAI compatible API
-
• 提升性能: 使得大模型在推理时更加快速和高效。
-
• 降低成本: 减少计算资源需求,降低云计算和硬件成本。
LangChain
简介: LangChain 是一个开源框架,旨在帮助开发者构建基于语言模型的应用。它通过提供一系列工具和组件,简化了语言模型与其他数据源、API 和服务的集成过程。LangChain 允许用户构建复杂的工作流,增强了语言模型的功能和灵活性,适用于多种应用场景。
网址:https://www.langchain.com/langchain
作用:
-
• 简化开发: 提供高层次的抽象,降低技术门槛。
-
• 增强功能: 扩展语言模型的能力,处理更复杂的任务。
部署方法
准备模型
由于上一章中训练的医疗大模型 随着容器的关闭已经被清理,所以本次实践选择了Qwen2-0.5B-Instruct。
git clone https://www.modelscope.cn/qwen/Qwen2-0.5B-Instruct.git
安装vLLM
pip install vllm
安装完毕后,可以通过如下命令查看安装情况
pip show vllm
运行结果:
Name: vllm
Version:0.5.1
Summary: A high-throughput and memory-efficient inference and serving engine forLLMs
Home-page: https://github.com/vllm-project/vllm
Author: vLLM Team
Author-email:
License:Apache2.0
Location:/usr/local/lib/python3.10/site-packages
Requires: aiohttp, cmake, fastapi, filelock, lm-format-enforcer, ninja, numpy, nvidia-ml-py, openai, outlines, pillow, prometheus-client, prometheus-fastapi-instrumentator, psutil, py-cpuinfo, pydantic, ray, requests, sentencepiece, tiktoken, tokenizers, torch, torchvision, tqdm, transformers, typing-extensions, uvicorn, vllm-flash-attn, xformers
Required-by:
部署vLLM
python -m vllm.entrypoints.openai.api_server --model Qwen2-0.5B-Instruct --host 0.0.0.0 --port 8000
❗
Qwen2-0.5B-Instruct对应模型的文件夹名字,由于Linux下文件路径大小写敏感,所以此处需要保持大小写一致。
成功部署后显示:
INFO:     Started server process [1657]
INFO:     Waiting for application startup.
INFO:     Application startup complete.
INFO:     Uvicorn running on http://0.0.0.0:8000 (Press CTRL+C to quit)
我们使用OpenAI compatible API接口测试部署情况:
from openai importOpenAI
# Set OpenAI's API key and API base to use vLLM's API server.
openai_api_key ="EMPTY"
openai_api_base ="http://localhost:8000/v1"

client =OpenAI(
    api_key=openai_api_key,
    base_url=openai_api_base,
)

chat_response = client.chat.completions.create(
    model="Qwen2-0.5B-Instruct",
    messages=[
{"role":"system","content":"你是一个很有用的助手。"},
{"role":"user","content":"中华人民共和国的首都是哪里?"},
]
)
print("Chat response:", chat_response)
运行结果:

上述的Python代码仅是测试vLLm的部署情况,实际应用中,需要使用
LangChain进行进一步封装。
使用nvidia-smi查看显存,可以看到显存已经被占用19G。
root@dsw-624205-75f5bf5ffb-cm59j:/mnt/workspace# nvidia-smi
ThuAug1517:29:212024
+-----------------------------------------------------------------------------+
| NVIDIA-SMI 470.103.01DriverVersion:470.103.01   CUDA Version:12.1|
|-------------------------------+----------------------+----------------------+
| GPU  NamePersistence-M|Bus-IdDisp.A |VolatileUncorr. ECC |
|FanTempPerfPwr:Usage/Cap|Memory-Usage| GPU-UtilCompute M.|
|||               MIG M.|
|===============================+======================+======================|
|0  NVIDIA A10          On|00000000:00:07.0Off|0|
|0%53C    P0    61W/150W|19874MiB/22731MiB|0%Default|
|||                  N/A |
+-------------------------------+----------------------+----------------------+

+-----------------------------------------------------------------------------+
|Processes:|
|  GPU   GI   CI        PID   TypeProcess name                  GPU Memory|
|        ID   ID                                                   Usage|
|=============================================================================|
+-----------------------------------------------------------------------------+
安装LangChain
pip install langchain-openai
使用LangChain
# 引入 OpenAI 支持库
from langchain_openai importChatOpenAI

# 连接信息
base_url ="http://localhost:8000/v1"
api_key ="EMPTY"
model_id ="Qwen2-0.5B-Instruct"

# 连接大模型
llm =ChatOpenAI(
        base_url=base_url,
        api_key=api_key,
        model=model_id
)

# 大模型调用
llm.invoke(input="你是谁?")
运行结果:
AIMessage(content='我是来自阿里云的大规模语言模型,我叫通义千问。',
additional_kwargs={
'refusal':None}, response_metadata={'token_usage':
{'completion_tokens':17,'prompt_tokens':22,'total_tokens':39},
'model_name':'Qwen2-0.5B-Instruct',
'system_fingerprint':None,
'finish_reason':'stop',
'logprobs':None},
id='run-ca1584a6-0ff5-4d49-bfb2-ad932231e762-0',
usage_metadata={'input_tokens':22,'output_tokens':17,'total_tokens':39})
返回信息
如果使用result = llm.invoke(input= "你是谁?"),然后查看result信息,可以查看更多信息。
-
• result.content
'我是来自阿里云的大规模语言模型,我叫通义千问。' -
• result.response_metadata
{'token_usage':{'completion_tokens':17, 'prompt_tokens':22, 'total_tokens':39}, 'model_name':'Qwen2-0.5B-Instruct', 'system_fingerprint':None, 'finish_reason':'stop', 'logprobs':None}说明: -
•
completion_tokens: 生成的文本中使用的令牌数。在这个例子中,生成的文本包含17个令牌(token)。 -
•
prompt_tokens: 输入提示中使用的令牌数。在这个例子中,输入的提示包含22个令牌。 -
•
total_tokens: 总令牌数,即completion_tokens和prompt_tokens的总和。在这个例子中,总令牌数为 39。 -
•
finish_reason: 表示生成文本的结束原因。在这个例子中,finish_reason的值为stop,意味着文本生成在达到预定条件后正常结束。 -
•
logprobs: 该字段通常用于提供生成过程中每个令牌的对数概率。在这个例子中,它的值为 None,表示没有提供这些信息。
补充内容
模型类型
模型常规情况下有两种类型:Base类型 和 Chat类型。
-
•
Qwen2-0.5B: 代表Qwen2-0.5B的Base类型模型。 -
•
Qwen2-0.5B-Instruct: 代表Qwen2-0.5B的Chat类型模型。
调用方式
由于模型的类型不同,那么在LangChain中调用方式也不同。
from langchain_openai import OpenAI

base_url = "http://localhost:8000/v1"
api_key = "EMPTY"
model_id = "Qwen2-0.5B-Instruct"

# Base方式调用了一个Chat类型模型
model = OpenAI(base_url=base_url, api_key=api_key, model=model_id)

print(model.invoke(input="你是谁"))
运行结果:

可以看到:
-
• 同样的模型,同样的问题,调用方式的不同,调用的结果却千差万别。
-
• 第一种使用
from langchain_openai import ChatOpenAI,即Chat方式调用一个Instruct类型模型,结果是正常的。 -
• 第二种使用
from langchain_openai import OpenAI,即Base方式调用一个Instruct类型模型,结果是有问题的。 -
• Chat方式返回的信息是一个AIMessage,而Base方式返回的是一个字符串。
内容小结
-
•
vLLM是一个专为大语言模型(LLMs)设计的高效推理库,旨在优化推理速度和内存使用。 -
•
LangChain是一个开源框架,旨在帮助开发者构建基于语言模型的应用。 -
•
vLLM和LangChain都可以使用pip install安装。 -
• 模型有嵌入类型和常规类型;常规类型下有
Base类型和Chat类型两种类型。 -
• 不同类型的模型调用方式不同,如果模型类型与调用方式没有对应,可能会出现结果异常。
零基础如何学习AI大模型
领取方式在文末
为什么要学习大模型?
学习大模型课程的重要性在于它能够极大地促进个人在人工智能领域的专业发展。大模型技术,如自然语言处理和图像识别,正在推动着人工智能的新发展阶段。通过学习大模型课程,可以掌握设计和实现基于大模型的应用系统所需的基本原理和技术,从而提升自己在数据处理、分析和决策制定方面的能力。此外,大模型技术在多个行业中的应用日益增加,掌握这一技术将有助于提高就业竞争力,并为未来的创新创业提供坚实的基础。
大模型典型应用场景
①AI+教育:智能教学助手和自动评分系统使个性化教育成为可能。通过AI分析学生的学习数据,提供量身定制的学习方案,提高学习效果。
②AI+医疗:智能诊断系统和个性化医疗方案让医疗服务更加精准高效。AI可以分析医学影像,辅助医生进行早期诊断,同时根据患者数据制定个性化治疗方案。
③AI+金融:智能投顾和风险管理系统帮助投资者做出更明智的决策,并实时监控金融市场,识别潜在风险。
④AI+制造:智能制造和自动化工厂提高了生产效率和质量。通过AI技术,工厂可以实现设备预测性维护,减少停机时间。
…
这些案例表明,学习大模型课程不仅能够提升个人技能,还能为企业带来实际效益,推动行业创新发展。
学习资料领取
如果你对大模型感兴趣,可以看看我整合并且整理成了一份AI大模型资料包,需要的小伙伴文末免费领取哦,无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

部分资料展示
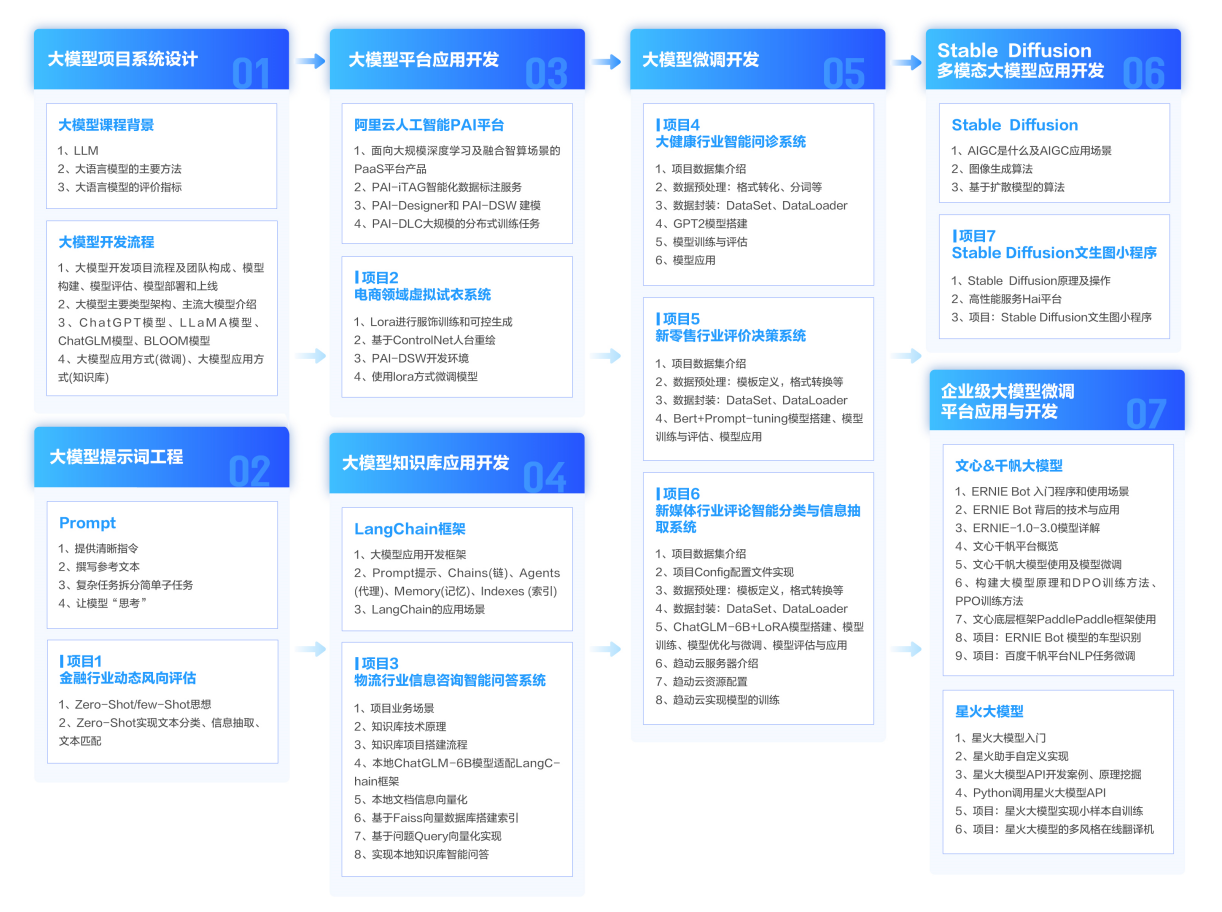
一、 AI大模型学习路线图
整个学习分为7个阶段

二、AI大模型实战案例
涵盖AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,皆可用。


三、视频和书籍PDF合集
从入门到进阶这里都有,跟着老师学习事半功倍。


四、LLM面试题


五、AI产品经理面试题

六、deepseek部署包+技巧大全

😝朋友们如果有需要的话,可以V扫描下方二维码联系领取~


聚焦RDK与具身智能,汇集机器人开发教程、开源案例和技术交流
更多推荐
 12
 0
- 0


 已为社区贡献12条内容

所有评论(0)