如何看待目前VLA的具身智能技术?
挺神奇的是,VLA初衷是不错的技术,但当下纯黑盒+数据 end2end 已到瓶颈期,已无更多提升空间,只能魔改网络。
VLA 当前的算法本质,就是过拟合,有的人说,那我采数据不得了?机器人任务需要的数据量,远远几个数量级的大于imageNet,至少应该是[万亿]个demonstration。所以暴力过拟合是没有未来的,会撞南墙,真正的AGI 还得smart一点,找到任务和场景共性。
前言:VLA 容易引导大量研究者,从深度研究机器人任务和场景,变成粗暴叠数据和魔改网络,简单任务上overfitting,弗雷哥希望大家多思考,多思考!
谨慎对待 VLA:从“摆拍式end2end泛化”到可解释机器人学习的路线图
现阶段多数 VLA(Vision-Language-Action)系统本质仍是升级版行为克隆(BC),靠大规模数据与算力“硬凿”效果,泛化脆弱、难以复现。
在任务难度、场景复杂度、维度数量增加后,数据需求和失败概率呈指数级爆炸;“pick-place 拼题式”评测掩盖了这一点。
真正可扩展的机器人智能必须以可解释的任务建模、3D几何/物理建模、可验证的控制与规划模块为核心,而不仅是端到端炼丹。
我提出一个更稳健的技术路线:任务解析 → 语义到几何的桥梁 → 结构化世界模型(SE(3)、拓扑/约束图→ 可解释策略合成→ 低层运动/力控制闭环 + 可靠评测协议。
建议行业建立标准化、多维度难度递增的 benchmark、严格的复现与统计报告规范,杜绝“摆拍式成功率”。 换句话说:闭眼炼丹 end2end 那一套,别再拿来糊弄人了。劣币驱逐良币的戏码,到我这里就刹车。 再直白点:这一锅端到端神药,我先翻个底朝天;谁再拿“玄学 trick”糊我,我就拿 SE(3) 当板砖拍回去。
1. 问题背景:为什么“语言巨人,行动矮子”?
先把丑话放前头:VLA 现在这套路数,真就是“语言巨人,行动矮子”。嘴上 AGI,手上 pick-place,嘴上说泛化,脚下全靠摆拍。
- 跨模态跨度过大:从自然语言直接映射到高维连续控制(Action),中间缺失了任务逻辑、物理约束、空间几何等关键桥梁。
- 数据与算力的“劣币逻辑”:堆数据/算力短期见效,但不可解释、不稳定、不可扩展;复杂任务下成本爆炸。
- 评测与宣传脱节:大量工作在最简单的 2D 桌面、少量物体、短轨迹下报“90%+ 成功率”;统计口径不透明,任务难度可被随意“调参”。
- 黑盒不可控:系统边界模糊——“能不能倒水/切洋葱/织毛衣?”没有可验证的阶段性能力定义和安全边界。
1.5 为什么公司还在推 VLA?(并不是因为它“效果好、通用、便宜、快”)
- 效果好吗?不是。 多数实验集中在极简任务与环境,真实复杂任务掉线严重。
- 通用性好吗?也不是。 脱离任务难度谈“通用”就是耍流氓——维度一增,立刻崩。
- 便宜吗?表面便宜。 省的是人类建模思考的“脑力成本”,贵的是暴力算力与海量数据采集/清洗。
- 推理快吗?是“快决策”,但“快”不等于“对”。抛开效果谈速度,同样是耍流氓。
ChatGPT 的成功无法直接迁移到机器人:语言到文本的映射距离远小于语言到高维连续控制。Action 这一步跨越过大,端到端大模型极易在 mapping 上失败。
行动远比视觉/语言复杂:一条完整的运动学/动力学轨迹涉及时空连续约束、接触力学、工具在手 manipulation 等,这些维度的数据极其稀缺,也难以标准化标注。

2. 典型 VLA 技术路径与症结
典型流水线:视觉编码器(或 VLM)→ 语言指令编码 → 融合模块 → 行为解码器(policy / value / affordance)→ 低层控制。
-
数据驱动的 BC/IL升级版:如 RT-1[2]、RT-2[1]、RT-X[3]、OpenVLA[4]、Pi0[5]、ReKep[6] 等,大多基于大量人类示教/视频/遥操作数据,配合序列建模或扩散策略。问题:
-
- 数据分布极窄:多为 pick-place、抓取等简单、单物体场景。
- 行为粒度粗/不一致:同一动作序列因示教者差异而带来巨大方差。
- 缺乏任务语义层的精确定义:靠 prompt/自然语言“拼凑”策略,导致泛化失效时难以解释。

-
“大模型 + 规划”尝试:PaLM-SayCan[7]、Code as Policies[8]、Inner Monologue[9]、LLM-As-Planner[10] 等让 LLM 负责高层分解,再调用策略库。问题:
-
- 语言规划与真实物理约束脱钩,需额外几何/动力学验证。
- 规划模块本身仍然不可解释/不可验证,且容易被 hallucination 误导。

- “演示合成/数据增强”类工作:GR-1[11]、RoboCasa[12]、DROID[13] 等通过合成或聚合多源数据提升覆盖面,但仍缺缺失严谨的 3D 约束与物理一致性检查。
未来工业和学术界,一定是可解释的泛化(强任务理解),不可能是莫名其妙,乱七八糟数据炼丹的泛化,如果莫名其妙,一定会伴随极其不稳定,不可复现的存在(除非任务简单+摆拍),不然任务难度每提高一级,场景复杂一点,数据需求一定会指数级(千倍)万倍,亿倍上升。
3. “指数爆炸”的本质:任务维度 × 场景复杂度
设任务复杂度由下列维度驱动:
- 对象数量与多样性(|O|)
- 空间自由度(姿态、遮挡、叠放、容器内外等)
- 动作序列长度/分支数(|A|,分层策略深度)
- 动力学与接触复杂度(力控制、柔性物体、液体)
在多数 VLA 架构中,训练样本需求近似与这些维度的组合呈指数关系(别问,问就是“一算就露馅”):
因此,当从“桌面单物体抓取”→“多物体遮挡+柔性物体操作+长序列”时,所需有效示例会暴涨 100×、1000× 乃至 1004345×(你要愿意吹,105、106 也行)。没有结构化归纳偏置(inductive bias)的模型,只能靠数据穷举——然后再告诉大家:看,我用 trick work 了。。
action 运动学轨迹本身复杂程度,远超language和vision本身,但数据又极其稀少。
举个例子:
vision:你识别一个脚上肿块组织,
language: 肿块组织不好,要及时切除
action: 精准从各种器械里找到手术刀,在手上in hand manipulation, 调解手术刀的位置,计算整个患者组织和手术刀的空间坐标系,不同策略和力度,剥离一层层组织,绕开血管,一点点从脚趾骨和经络旁边剥离这个肿块组织,
4. “摆拍式泛化”六大常见套路(请对号入座)
友情提示:以下任何一条你中了,成功率别报 90%,报个“幽默 60%”都算老实人。
**1)任务拆名不拆实:**把同一类 pick-place 伪装成几十个“任务名”。
首先最重要的,选个最简单的任务,
任务极其简单,也就是pick-place:
抓起来,放下去,抓起来,放下去。

多一个曲线或者多步骤轨迹,系统都直接发散无法收敛了
把百事可乐放在余华《活着》上面
把七喜放在《天利三十八套》上面
把可口可乐放在《泰勒新专辑》上面
把全脂牛奶放在梵高《星空》上面
把脱脂牛奶放在农夫山泉右边
把蜜雪冰城柠檬水放在线性代数左边 ………
恭喜你,100 个“通用任务”到手,其实都是一个 pick-place。万能 60%,闭眼都能过审。
很多人比较搞笑,他们为了装逼,pick-place,不叫pick-place,还无限细分,这样隐藏自己10个task,实际上就是一个task。
比如: put the bottle on the desk
比如:pick the pen to the pencil case
比如:move the bowl on the box
你但凡选个倒水,叠衣服,刷盘子,之类的,大概率0.001%的成功率起步,不给0%是因为过不了初审,但弗雷哥要说,倒水这个任务,vla肯定是0%起步。
2)背景极简:纯色桌面 + 1~2 个物体,避免视觉干扰。
通常就是桌面上,完完全全纯色的背景,
背景就只有一个物体,最多两个物体。
多一个都怕出错。只能1-2个。
但人类生活中,肯定是非常clutter的环境,所以1-2个物体,这种情况根本不存在。
以下场景VLA全GG:

3) 二维近似:忽略三维姿态/遮挡/容器/嵌套等情形。
人类是生活在3D空间,很多情景,
1) 物体是有空间位子position和姿态orientation变化
2)物体几个是很可能overlap到一起的
比如以下3D情况,VLA根本无法处理。

4) 统计口径模糊:采样次数、失败处理、难度分级不公开。
5) 人类干预没算进公式:失败重置、示教再来、后期剪辑不透明。
6) demo 挑选最佳角度:镜头、光照、抓取点都事先调好。
7)VLA 就是一个BC
本身理论上来说,AI应该观察人类一次演示数据就OK的,但是,目前VLA,需要几百次数据,做一个单一2D场景,pick place的简单任务,跟大算力枚举,基本没区别,真是糟蹋算力。
一个任务,最多3次few shots了,再教下去,没有耐心了,谈什么智能。
弗雷哥给女朋友演示3次倒牛奶,她都不会。
后续的 VLA 本质上就是一个升级版BC,没有太多新的东西。
很多纯CS出身的人,常常陷入误区,效果不好是因为这个框架可以微调改进,效果从90%可以微调到95%,哦耶,这样赢了。
问题是,本身90%这个,效果就是极其不科学的计算出来的准确率,成功率,摆拍30次,成功了27次,你给我说你这个任务成功率90%。
弗雷哥揭露这些人,怎么得出90%的这个效果的,实际上你成功率100%都可以,完全你自己去控制难度。
重点来了:机器人理解学习人类世界,必须利用空间几何计算进行modeling ,所以只有建立在 interpretable 的 robot learning 才是稳扎稳打,才是一步一个脚印地发展技术,建立护城河。任何一片不包含几何计算的robot learning的论文,都是地基不稳,后面误差完全不可控,苦海无边回头是岸。
所以说,现在公司主流的都是VLA,包括DeepMind Gemini Robots, 还有一种公司都采用VLA技术,为什么呢?
- 因为效果好吗?不是,效果极差
- 因为通用性好吗?不是,抛开任务难度谈通用是耍流氓。
- 因为便宜吗?是,也不是。便宜的是人脑,让人类不需要思考这么多,贵的是算力,因为暴力求解需要大量算力。
- 因为推理速度快吗?啊对,他就是可以很快抉择,就是快。指整个系统在新的任务下和指令干预下,响应速度快。但是抛下效果谈速度,就是耍流氓。
ChatGPT的成功,没办法复现在机器人上。只能做一个上层接口,action这一步,跨得太大,大模型,注定会 mapping 失败。 什么rekep,还有一堆pi0的demo,没有一个敢放到icra和iros给大家展示,一展示,摆拍的套路,全露馅。
最最最重要的来了:Boundary 不清晰,完全黑盒是最致命的弱点。
你根本不清楚,VLA到哪个阶段可以做什么任务。比如VLA哪个阶段可以切洋葱,哪个阶段可以织毛衣,哪个阶段可以拆笔记本电脑、哪个阶段可以做手术?
完完全全都未知,或者说完全不可能。
VLA鼓吹的zero shot,怎么可能呢?连人都做不到zero shot,哦,你没见过洋葱,你没拨过洋葱,你如何莫名其妙让ChatGPT给你,倒水,扫地,抓拿放,关门等一些列,一点不相关任务,
莫名其妙涌现,拨洋葱技能,哦,我涌现了复杂的拨洋葱skill,
如果你一层一层一层地拨开目前end2end的 VLA的洋葱内心,你会发现,你会鼻酸,你发现什么tm的都没有哦。都是一团酱胡。
弗雷哥眼里真的的robot learning未来可靠的路径:
模块化视角(Language → Task Graph → Geometry → Control)
1) 任务解析与逻辑建模
-
- 将自然语言解析成 任务图/选项图(options/skills),包含前置条件/后置条件、约束、失败恢复策略。
- 引入形式化语言(例如 PDDL、Signal Temporal Logic)作为可验证的中间表示
- 把任务分成基本的构成单元 element,能够解析 key 步骤,每个任务步骤都可以 track
2) 语义-几何桥梁(Semantic→Geometric Grounding)
-
- 构建 3D 场景图:物体位姿、接触关系、可达性、力约束。
- 使用 SE(3) Transformer、Equivariant Networks、Neural Fields/Occupancy ,高斯泼溅等显式建模空间 (一切运动轨迹都能可控可算,可解释性的呈现)。
3) 可解释策略合成
-
- 组合技能库(motion primitives、操作技能)+ 搜索/优化(MPC、RRT*、CHOMP)。
- 策略是可视化的:能被审查、调试、重用,不是黑盒 token 序列。
4) 低层控制闭环
-
- 力/位姿闭环控制、接触模型(impedance control)、实时状态估计。
- 模型预测控制(MPC)或分层 RL(高层 symbolic / 低层 continuous)
数据策略:少而精 vs 海量同质
- 少样本示教(3~5 次)应成为目标,甚至one shot,通过结构化归纳偏置提升数据效率。
- 真实世界 + 仿真域随机化结合,但仿真需保证几何/物理一致性,而非仅纹理随机化。
- 标准化数据协议:记录任务难度、失败样本、reset 方式、时间戳等,公开原始和失败案例。
评测与复现规范
- 难度分级基准:对象数、遮挡程度、姿态变化、柔性/液体、长序列等维度分层。
- 统计学报告:置信区间(Wilson/Binomial CI)、显著性检验、随机种子、试验次数。
- 公开失败视频与策略日志:避免“成功片段剪辑”。
- 跨实验室复现:提供校准流程(传感器、机械臂参数)、统一任务定义与评分脚本。
弗雷哥不是不鼓励大家用AI,弗雷哥完全不鼓励,没有一点modeling,没有一点可解释性,没有一点水平,没有一点对于机器人任务和场景本身理解和建模的系统。
纯End2end,视觉对齐尚且一大堆问题,更复杂,更具有挑战性的动态物理世界,问题远比视觉对齐难100倍。因此目前框架肯定不太可能实现VLA的爆发增长
[1] RT-1: Brohan, A., et al. (2022). RT-1: Robotics Transformer for Real-World Control at Scale. In Proceedings of Robotics: Science and Systems (RSS).
[2] RT-2: Brohan, A., et al. (2023). RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control. arXiv preprint arXiv:2307.15818.
[3] RT-X: Brohan, A., et al. (2023). Open X-Embodiment: Robotic Learning Datasets and RT-X Models. Project Website.
[4] OpenVLA: Kim, M. J., et al. (2024). OpenVLA: An Open-Source Vision-Language-Action Model. In Conference on Robot Learning (CoRL).
[5] π₀ (Pi-Zero): Physical Intelligence, Inc. (2024). π₀: A Foundation Model for Robotics. Project Website and Technical Announcements.
[6] ReKep: Bai, Y., et al. (2024). ReKep: Relational Keypoint Constraints for Category-Level Robotic Manipulation. arXiv preprint arXiv:2409.01652.
[7] PaLM-SayCan: Ahn, M., et al. (2022). Do As I Can, Not As I Say: Grounding Language in Robotic Affordances. arXiv preprint arXiv:2204.01691.
[8] Code as Policies: Liang, J., et al. (2023). Code as Policies: Language Model Programs for Embodied Control. In IEEE International Conference on Robotics and Automation (ICRA).
[9] Inner Monologue: Huang, W., et al. (2023). Inner Monologue: Adding Unseen Tools to a Robot’s Repertoire. In Conference on Robot Learning (CoRL).
[10] LLM-As-Planner: Singh, I., et al. (2023). ProgPrompt: Generating Situated Robot Task Plans using Large Language Models. In IEEE International Conference on Robotics and Automation (ICRA).
[11] GR-1: Fourier Intelligence (2023). Fourier GR-1 Humanoid Robot Introduction. Technical Datasheet. (GR-1是商业化机器人,其技术细节主要通过官方技术手册和公告发布)。
[12] RoboCasa: Weng, Z., et al. (2024). RoboCasa: Large-Scale Simulation of Everyday Tasks for Generalist Robots. arXiv preprint arXiv:2405.18833.
umanoid Robot Introduction*. Technical Datasheet. (GR-1是商业化机器人,其技术细节主要通过官方技术手册和公告发布)。
[12] RoboCasa: Weng, Z., et al. (2024). RoboCasa: Large-Scale Simulation of Everyday Tasks for Generalist Robots. arXiv preprint arXiv:2405.18833.
[13] DROID: Lakshmiprasad, A., et al. (2024). DROID: A Large-Scale In-the-Wild Robot Manipulation Dataset. arXiv preprint arXiv:2403.02021.
零基础如何高效学习大模型?
你是否懂 AI,是否具备利用大模型去开发应用能力,是否能够对大模型进行调优,将会是决定自己职业前景的重要参数。
为了帮助大家打破壁垒,快速了解大模型核心技术原理,学习相关大模型技术。从原理出发真正入局大模型。在这里我和鲁为民博士系统梳理大模型学习脉络,这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码免费领取🆓**⬇️⬇️⬇️
【大模型全套视频教程】
教程从当下的市场现状和趋势出发,分析各个岗位人才需求,带你充分了解自身情况,get 到适合自己的 AI 大模型入门学习路线。
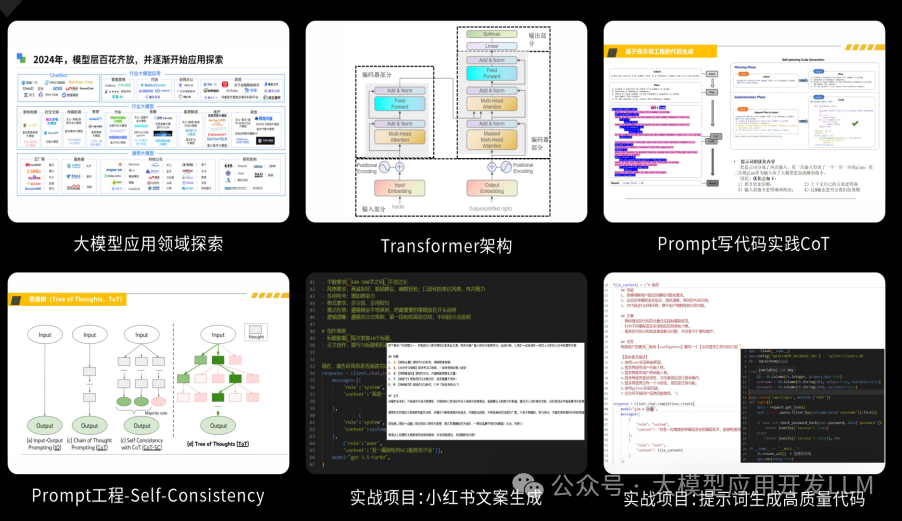
从基础的 prompt 工程入手,逐步深入到 Agents,其中更是详细介绍了 LLM 最重要的编程框架 LangChain。最后把微调与预训练进行了对比介绍与分析。
同时课程详细介绍了AI大模型技能图谱知识树,规划属于你自己的大模型学习路线,并且专门提前收集了大家对大模型常见的疑问,集中解答所有疑惑!
深耕 AI 领域技术专家带你快速入门大模型
跟着行业技术专家免费学习的机会非常难得,相信跟着学习下来能够对大模型有更加深刻的认知和理解,也能真正利用起大模型,从而“弯道超车”,实现职业跃迁!
【AI 大模型面试题 】
除了 AI 入门课程,我还给大家准备了非常全面的**「AI 大模型面试题」,**包括字节、腾讯等一线大厂的 AI 岗面经分享、LLMs、Transformer、RAG 面试真题等,帮你在面试大模型工作中更快一步。
【大厂 AI 岗位面经分享(92份)】
【AI 大模型面试真题(102 道)】
【LLMs 面试真题(97 道)】
【640套 AI 大模型行业研究报告】
【AI大模型完整版学习路线图(2025版)】
明确学习方向,2025年 AI 要学什么,这一张图就够了!
👇👇点击下方卡片链接免费领取全部内容👇👇
抓住AI浪潮,重塑职业未来!
科技行业正处于深刻变革之中。英特尔等巨头近期进行结构性调整,缩减部分传统岗位,同时AI相关技术岗位(尤其是大模型方向)需求激增,已成为不争的事实。具备相关技能的人才在就业市场上正变得炙手可热。
行业趋势洞察:
- 转型加速: 传统IT岗位面临转型压力,拥抱AI技术成为关键。
- 人才争夺战: 拥有3-5年经验、扎实AI技术功底和真实项目经验的工程师,在头部大厂及明星AI企业中的薪资竞争力显著提升(部分核心岗位可达较高水平)。
- 门槛提高: “具备AI项目实操经验”正迅速成为简历筛选的重要标准,预计未来1-2年将成为普遍门槛。
与其观望,不如行动!
面对变革,主动学习、提升技能才是应对之道。掌握AI大模型核心原理、主流应用技术与项目实战经验,是抓住时代机遇、实现职业跃迁的关键一步。
01 为什么分享这份学习资料?
当前,我国在AI大模型领域的高质量人才供给仍显不足,行业亟需更多有志于此的专业力量加入。
因此,我们决定将这份精心整理的AI大模型学习资料,无偿分享给每一位真心渴望进入这个领域、愿意投入学习的伙伴!
我们希望能为你的学习之路提供一份助力。如果在学习过程中遇到技术问题,也欢迎交流探讨,我们乐于分享所知。
*02 这份资料的价值在哪里?*
专业背书,系统构建:
-
本资料由我与鲁为民博士共同整理。鲁博士拥有清华大学学士和美国加州理工学院博士学位,在人工智能领域造诣深厚:
-
- 在IEEE Transactions等顶级学术期刊及国际会议发表论文超过50篇。
- 拥有多项中美发明专利。
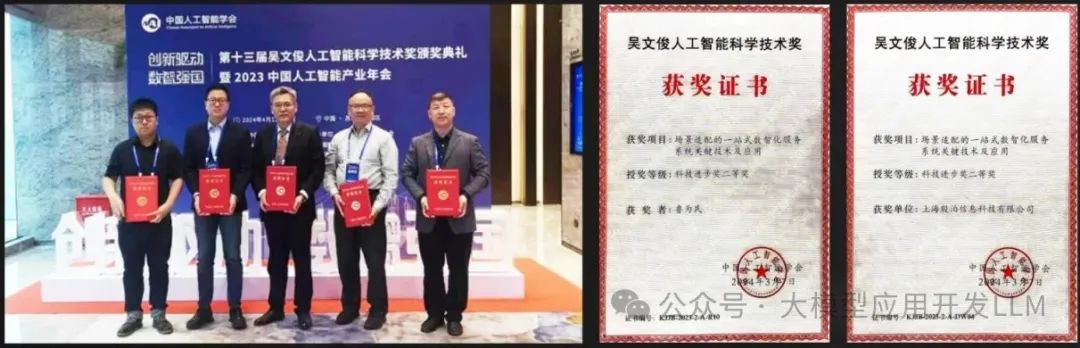
- 荣获吴文俊人工智能科学技术奖(中国人工智能领域重要奖项)。
-
目前,我有幸与鲁博士共同进行人工智能相关研究。
内容实用,循序渐进:
-
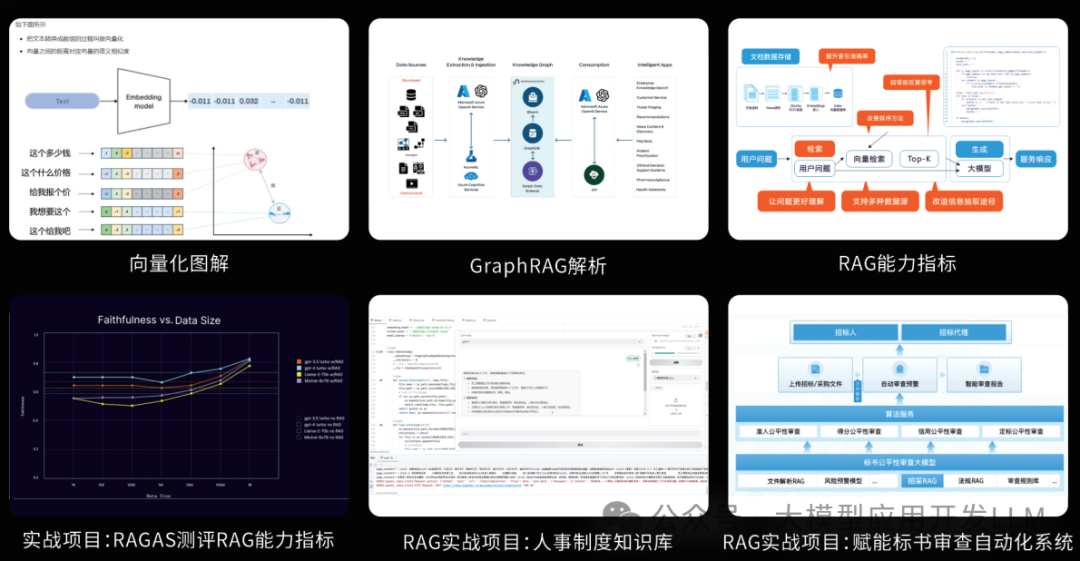
资料体系化覆盖了从基础概念入门到核心技术进阶的知识点。
-
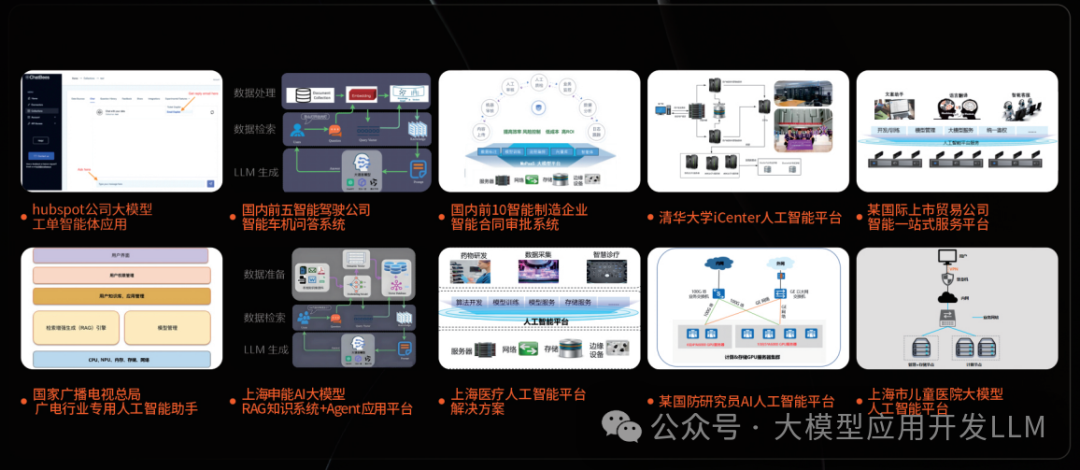
包含丰富的视频教程与实战项目案例,强调动手实践能力。
-
无论你是初探AI领域的新手,还是已有一定技术基础希望深入大模型的学习者,这份资料都能为你提供系统性的学习路径和宝贵的实践参考,助力你提升技术能力,向大模型相关岗位转型发展。
抓住机遇,开启你的AI学习之旅!

聚焦RDK与具身智能,汇集机器人开发教程、开源案例和技术交流
更多推荐
 21
 0
- 0


 已为社区贡献3条内容

所有评论(0)