为什么Ollama成为大模型部署标准?从架构到性能的全方位技术解析,值得收藏学习!
当市面上充斥着各种本地大模型部署工具时,Ollama以一种近乎傲慢的姿态,成为了事实上的标准。它成功的背后,绝非简单的“易用性”三个字可以概括。本文将从架构抉择、性能压榨、生态野心三个维度,进行一次不留情面的技术解剖,告诉你它为何是王者,以及它的软肋何在。

一、架构哲学:为何“Go + C++”是降维打击?
平庸的工具解决功能,优秀的工具设计范式。Ollama的架构选择,是一次对传统Python生态的“降维打击”。
- C++核心(llama.cpp):性能的绝对底线
- 超越量化:内存访问模式的终极优化:所有人都谈量化,但Ollama底层使用的GGUF格式,其精妙在于内存对齐与预计算。它通过将权重分组并按特定格式(如
q4\_0的块结构)排布,使得在推理时,CPU/GPU的SIMD指令能够实现最大化吞吐。这不仅仅是体积减小,更是内存带宽瓶颈的系统性解决方案。 - 硬件后端的“抽象艺术”:
llama.cpp并非简单调用CUDA或Metal,它构建了一个高效的硬件抽象层。对Apple Silicon,它深度利用MPS(Metal Performance Shaders),通过MPSTemporaryTensor避免不必要的内存拷贝;对NVIDIA,它则基于CUDA的cuBLAS和自定义Kernel。这种设计使得向上提供统一接口,向下则能压榨各平台极限性能。
- Go语言层:工程化的“上帝之手”
- 并发模型与资源隔离:Go的Goroutine和Channel机制,天然适合处理并发的推理请求与流式输出。更重要的是,其动态加载器 实现了模型的“进程级沙箱”。当一个模型被卸载时,其占用的GPU内存可以被真正释放,这是Python因GIL和全局状态问题难以做到的关键工程优势。
- 静态编译:依赖地狱的终结者:一个二进制文件,包含所有依赖。这种极致的简洁,彻底解决了“在我机器上能跑”的千古难题,是它得以快速普及的第一推动力。
个人观点: Ollama的架构,本质上是将云原生基础设施的思想(如容器、编排)应用到了本地模型运行时。它把复杂的llama.cpp编译过程和模型管理,变成了一个声明式的、可配置的、可编排的系统服务。
下图描绘了端到端的软件架构:

二、性能真相:快,是一种多维度的综合体验
外行看Tokens/s,内行看端到端延迟和资源效率。Ollama的“快”是一个系统工程。
- 推理优化的“三重奏”
- 量化策略的暴力美学:
q4\_0是目前性价比的黄金标准,但Ollama支持的q2\_K、q6\_K等提供了更精细的权衡曲线。真正的行家会根据任务选择模型:代码生成对精度敏感,可用q8\_0;纯聊天场景,q4\_0足矣。 - GPU Offloading的智能策略:Ollama并非将整个模型图丢给GPU。其底层会进行层级调度,根据可用显存,优先将计算和内存最密集的层(如Attention中的QKV投影)Offload到GPU,其余部分留在CPU。这种混合计算模式是其在有限资源下保持流畅的秘诀。
- 推理前优化:在模型加载阶段,Ollama会进行计算图优化和内核预选择,根据硬件特性选择最合适的内核,避免了运行时动态选择的开销。
- 被忽视的“内存管理艺术”
- KV Cache的精细管理:长上下文对话的核心瓶颈。Ollama通过集成
llama.cpp的flash\_attn等优化,将KV Cache的内存复杂度从O(n²)降至线性,并实现了循环缓存,在对话延续时无需重新计算,这是其能处理超长文档的技术底气。 - 内存映射I/O:利用
mmap等技术,实现模型文件的懒加载,大幅降低启动时的内存压力和延迟。
个人观点: Ollama的性能优势,不在于其单项跑分能超越手工优化的C++代码,而在于它在整个系统层面——从磁盘I/O、内存管理、计算调度到网络响应——实现了无短板的、稳定的高性能。这是一种面向产品的工程思维,而非面向benchmark的学术思维。
三、生态野心:它正在悄悄制定游戏规则
Ollama的终极目标,是成为本地LLM世界的“Kubernetes”。
- OpenAI API兼容:生态的“特洛伊木马”
- 这一设计是天才之举。它意味着整个AI应用生态(如LangChain、AutoGPT)可以零成本地接入Ollama。开发者只需改变
base\_url,就能让他们的应用在云端大模型和本地私有模型之间无缝切换。这极大地降低了本地模型的使用门槛,构筑了强大的生态护城河。
- Modelfile:模型即代码的实践
Modelfile不仅仅是参数配置,它是一个可复现的模型部署单元。你可以将系统提示词、推理参数、模板固化下来,通过ollama create生成一个定制的模型版本。这已经进入了MLOps的范畴,为团队协作和模型管理提供了基础设施。
- Library:自建模型仓库的野望
- 官方的模型库只是开始。Ollama支持从自定义地址拉取模型,这为企业搭建内部模型仓库铺平了道路。结合
Modelfile,企业可以标准化其内部的模型部署流程。
个人观点: Ollama正在做的事情,是对AI模型分发和部署方式的范式革命。它试图将模型从一个个孤立的、需要复杂环境配置的“科研项目”,转变为标准化、可管理、可编排的“软件组件”。
四、批判与挑战:Ollama的“致命弱点”
一个客观的技术批判,必须指出其弱点。
- 可观测性不足:缺乏像Prometheus那样成熟的指标暴露接口,对于监控模型的内存占用、推理延迟、吞吐量等关键运维指标,目前支持较弱。
- 多模型实例的资源争抢:虽然支持动态加载,但当多个模型实例同时运行时,其资源仲裁策略相对简单,可能引发性能抖动,缺乏像cgroups那样的强隔离能力。
- 对“非主流”硬件的支持滞后:其对Intel ARC显卡、AMD ROCm等平台的支持,通常要晚于NVIDIA CUDA和Apple Metal,这限制了其在更广阔硬件生态的普及。
五、总结:Ollama重新划定了起跑线
Ollama的成功告诉我们,在AI工程化领域,极致的用户体验和清晰的架构设计,其价值不亚于算法本身的微末提升。它通过一套完整的工程体系,将本地LLM推理从一种“极客行为”,变成了一个可靠、可用的技术组件。
但 Ollama 的致命弱点也清晰划定了其能力边界:高并发场景下的吞吐量瓶颈、分布式部署能力的缺失,以及显存利用率的先天不足,使其难以支撑生产级服务需求。这正是 vLLM 成为主流选择的核心原因 —— 它以 PagedAttention 技术为支点,将显存利用率提升至 90% 以上,吞吐量可达 Ollama 的 10 倍以上,100 用户并发下仍能保持稳定输出;更通过张量并行、流水线并行技术实现多机多卡分布式部署,轻松扛住每秒数千次的推理请求。反观 Ollama,100 用户并发时请求超时率高达 37%,70B 模型显存占用比 vLLM 多出 23%,这些短板让它只能退守本地单机探索、小团队 Demo 验证等低并发细分领域,而企业级智能客服、大规模 API 服务等核心场景,自然成为 vLLM 的主场。
六、AI大模型从0到精通全套学习大礼包
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
只要你是真心想学AI大模型,我这份资料就可以无偿共享给你学习。大模型行业确实也需要更多的有志之士加入进来,我也真心希望帮助大家学好这门技术,如果日后有什么学习上的问题,欢迎找我交流,有技术上面的问题,我是很愿意去帮助大家的!
如果你也想通过学大模型技术去帮助就业和转行,可以扫描下方链接👇👇
大模型重磅福利:入门进阶全套104G学习资源包免费分享!
01.从入门到精通的全套视频教程
包含提示词工程、RAG、Agent等技术点
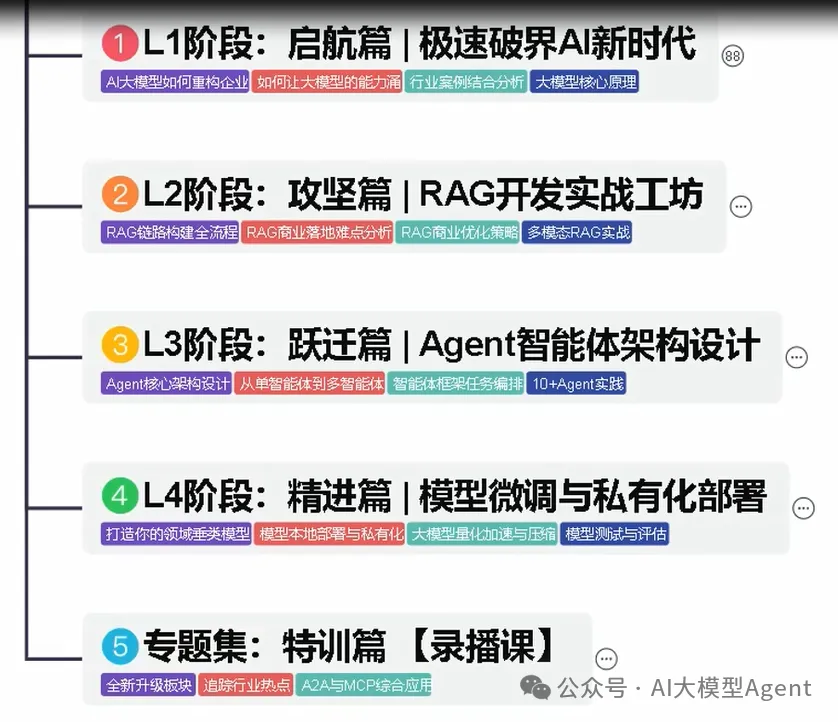
02.AI大模型学习路线图(还有视频解说)
全过程AI大模型学习路线
03.学习电子书籍和技术文档
市面上的大模型书籍确实太多了,这些是我精选出来的
04.大模型面试题目详解
05.这些资料真的有用吗?
这份资料由我和鲁为民博士共同整理,鲁为民博士先后获得了北京清华大学学士和美国加州理工学院博士学位,在包括IEEE Transactions等学术期刊和诸多国际会议上发表了超过50篇学术论文、取得了多项美国和中国发明专利,同时还斩获了吴文俊人工智能科学技术奖。目前我正在和鲁博士共同进行人工智能的研究。
所有的视频由智泊AI老师录制,且资料与智泊AI共享,相互补充。这份学习大礼包应该算是现在最全面的大模型学习资料了。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
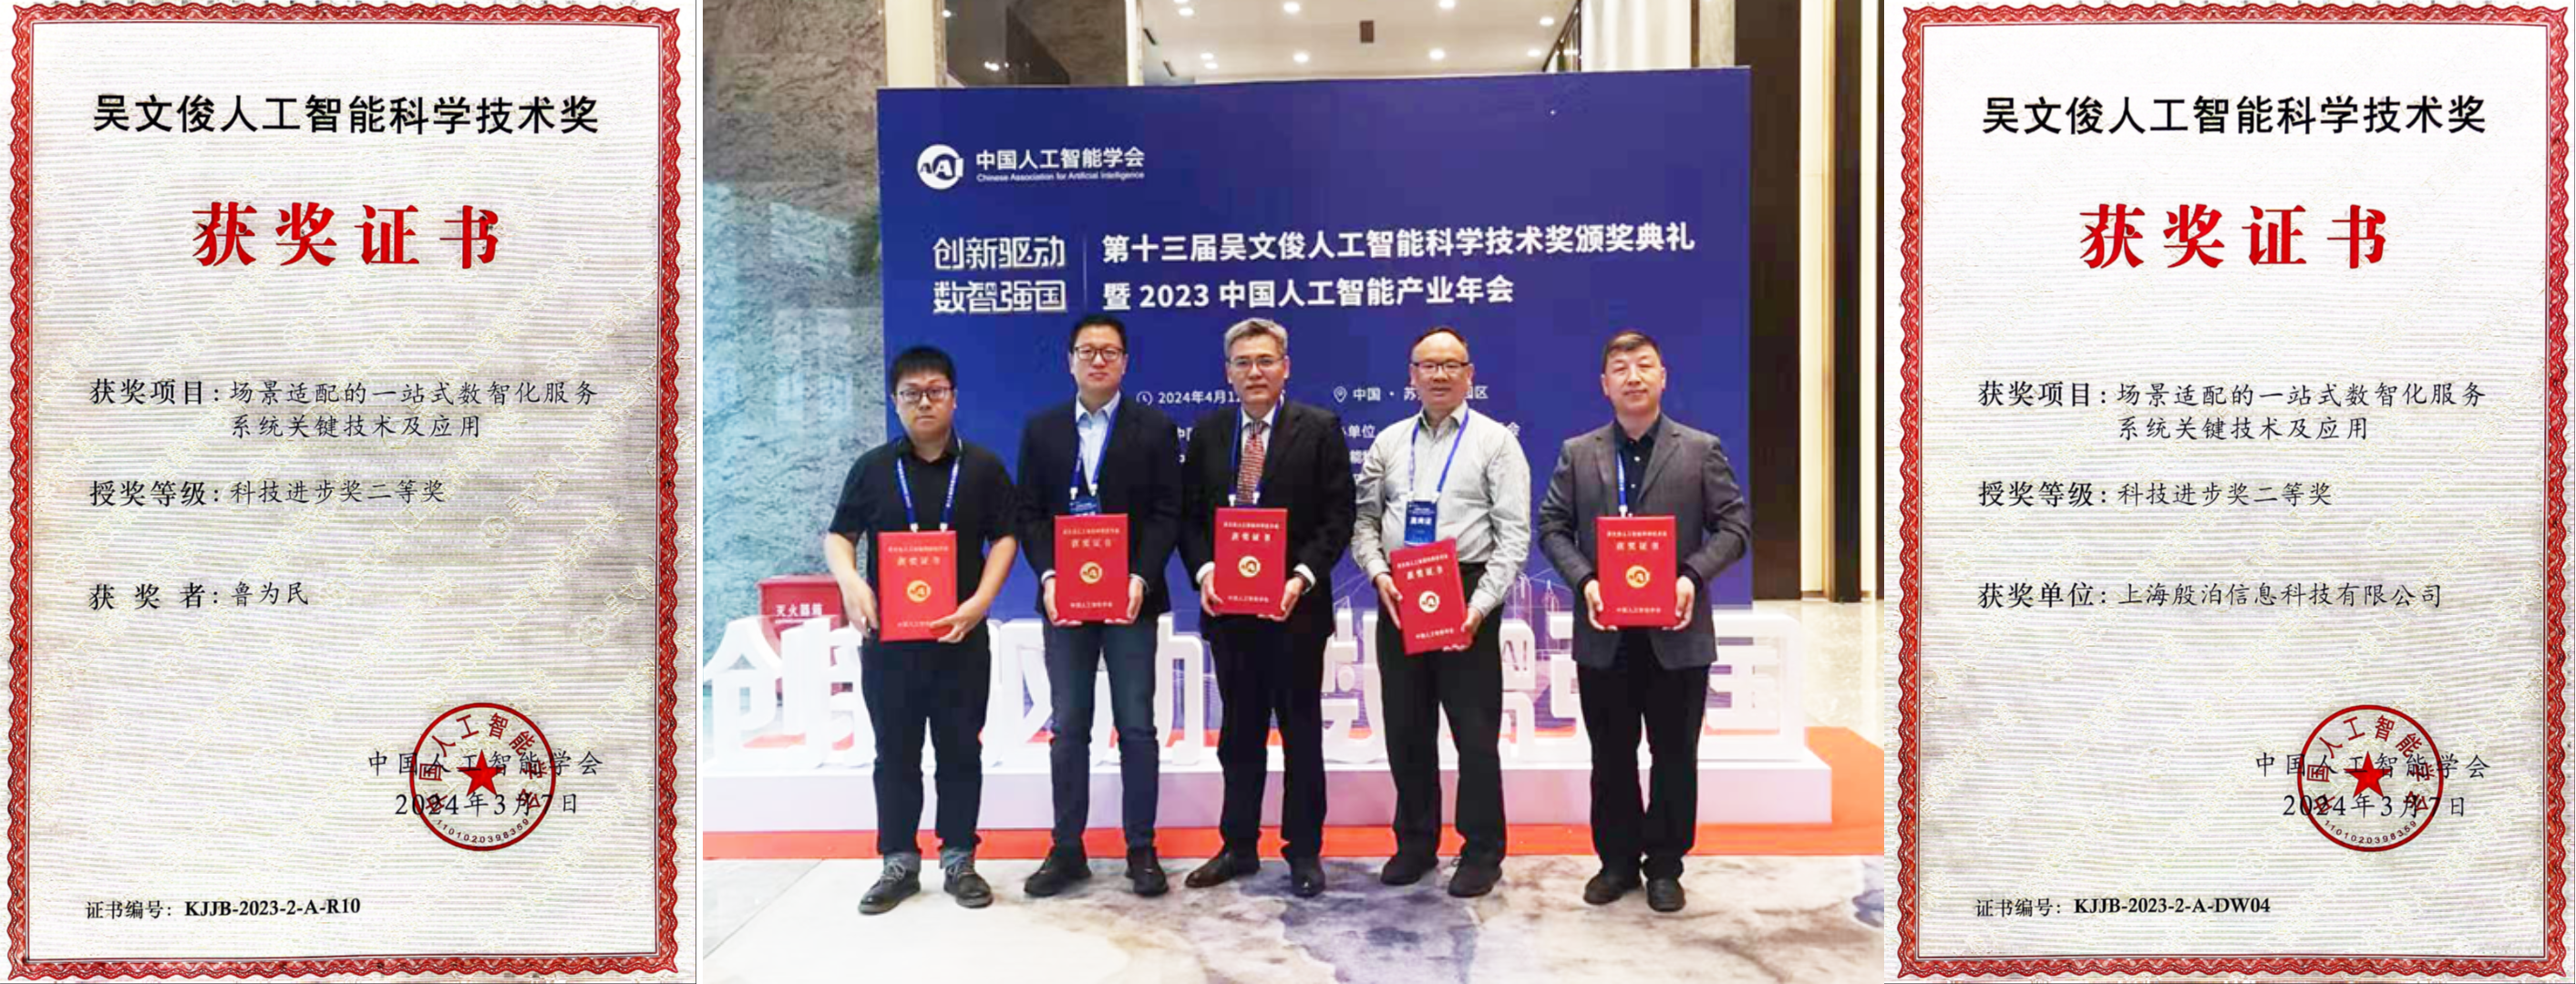
智泊AI始终秉持着“让每个人平等享受到优质教育资源”的育人理念,通过动态追踪大模型开发、数据标注伦理等前沿技术趋势,构建起"前沿课程+智能实训+精准就业"的高效培养体系。
课堂上不光教理论,还带着学员做了十多个真实项目。学员要亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事!
如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!
应届毕业生:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能 突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。
👉获取方式:
😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓

聚焦RDK与具身智能,汇集机器人开发教程、开源案例和技术交流
更多推荐
 26
 0
- 0


 已为社区贡献6条内容

所有评论(0)