Qwen3-VL:30B飞书智能助手搭建教程:从模型部署到控制台Chat页面端到端演示
Qwen3-VL:30B飞书智能助手搭建教程:从模型部署到控制台Chat页面端到端演示
想不想在飞书里拥有一个能看懂图片、能回答问题的“全能同事”?比如,直接把一张复杂的图表丢进群聊,它就能帮你分析数据趋势;或者上传一张产品设计图,它就能给出修改建议。今天,我就带你从零开始,在CSDN星图AI云平台上,亲手搭建一个基于最强多模态大模型Qwen3-VL:30B的飞书智能助手。
整个过程就像搭积木,我们会分两步走:上篇(本文)聚焦于在星图平台私有化部署Qwen3-VL:30B大模型,并让它成功在Clawdbot的控制台里“跑起来”,和我们对话。下篇则会完成最后一步,将这个强大的“大脑”正式接入飞书,让它成为你团队中的一员。
不用担心复杂,跟着步骤来,你也能拥有一个专属的、功能强大的AI办公助手。
1. 准备工作:认识我们的“工具箱”
在开始动手之前,我们先快速了解一下这次搭建会用到的几个核心“零件”,明白它们各自的作用,后面操作起来会更清晰。
- CSDN星图AI云平台:这是我们的“工作台”和“动力源”。它提供了现成的、配置好的GPU服务器(算力实例),我们不需要自己购买昂贵的显卡,也不用折腾复杂的驱动和环境安装,开箱即用。
- Qwen3-VL:30B镜像:这是已经预装好Qwen3-VL:30B模型及其运行环境(Ollama)的“软件包”。在星图平台,我们直接选择这个社区镜像启动实例,就等于获得了一台已经装好最强多模态AI模型的服务器。
- Ollama:一个非常流行的大模型本地运行和管理的工具。你可以把它想象成模型的“启动器和管理器”。我们通过它提供的Web界面或API,来和Qwen3-VL:30B对话。
- Clawdbot:这是我们本次项目的“桥梁”和“控制中心”。它本身是一个机器人框架,负责连接不同的AI模型(比如我们的Qwen3-VL)和外部通讯平台(比如飞书)。我们先在它的Web控制台里调试好机器人,后续再接入飞书。
简单来说,流程就是:在星图平台用Qwen3-VL镜像启动服务器 -> 服务器里通过Ollama运行模型 -> 安装Clawdbot并配置它去调用本地的Ollama服务 -> 最终在Clawdbot的Chat页面测试成功。
下面,我们正式进入操作环节。
2. 第一步:在星图平台启动Qwen3-VL:30B实例
我们的第一步,是获得一台已经装好模型的云服务器。
2.1 选择并创建实例
- 登录CSDN星图AI云平台,进入控制台。
- 在创建实例的页面,找到“社区镜像”选项。在搜索框中输入
Qwen3-vl:30b,快速定位到我们需要的镜像。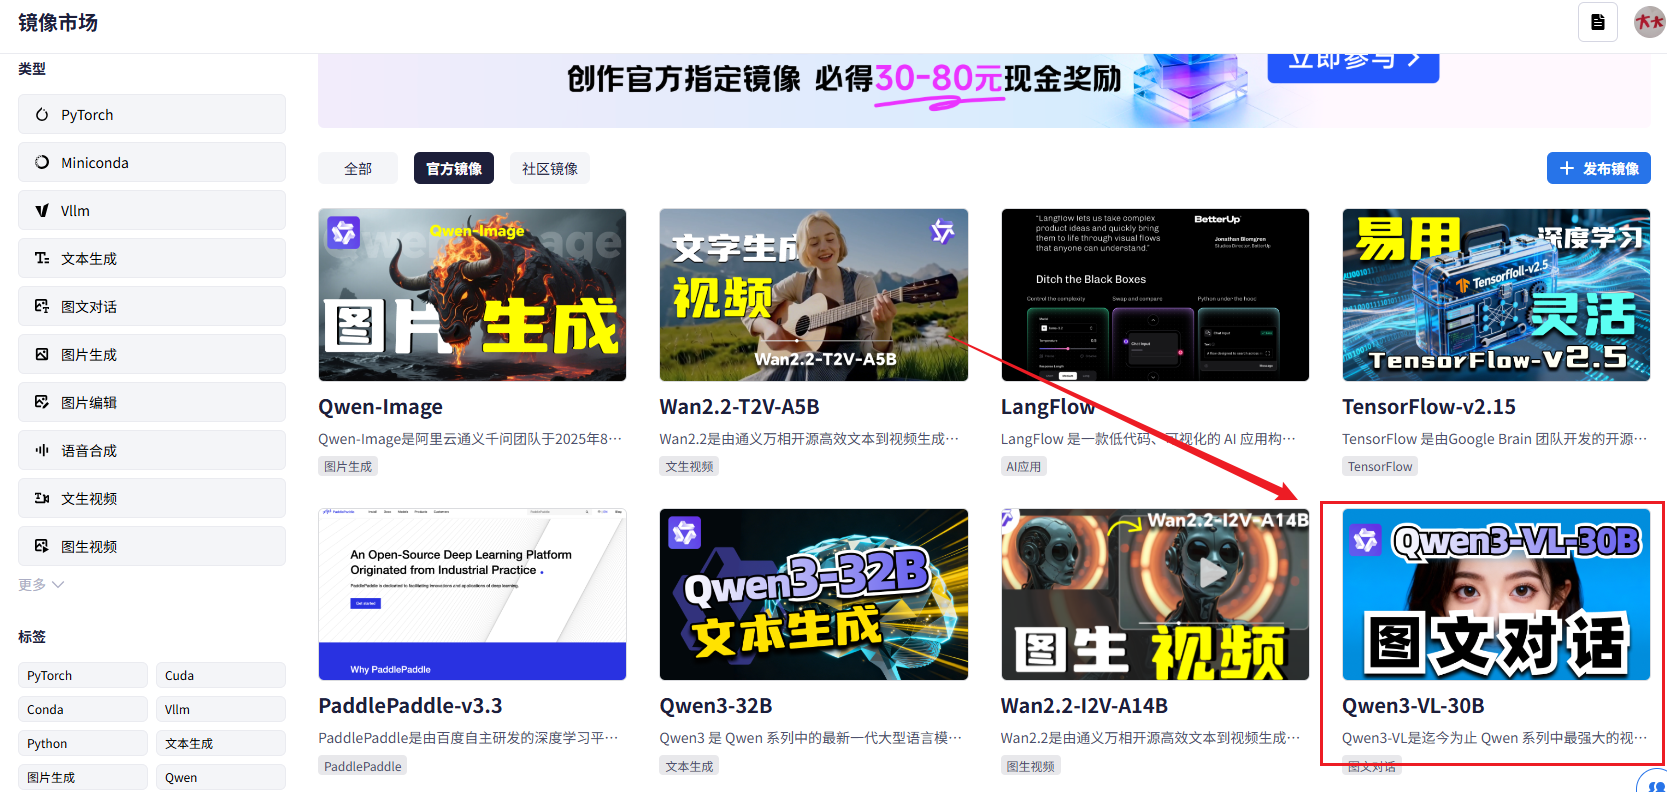
- 选择该镜像。Qwen3-VL:30B是一个300亿参数的大模型,对显卡要求较高。平台会为你推荐合适的配置(通常需要48GB显存)。我们直接采用默认推荐的GPU配置即可,这样能保证模型流畅运行。
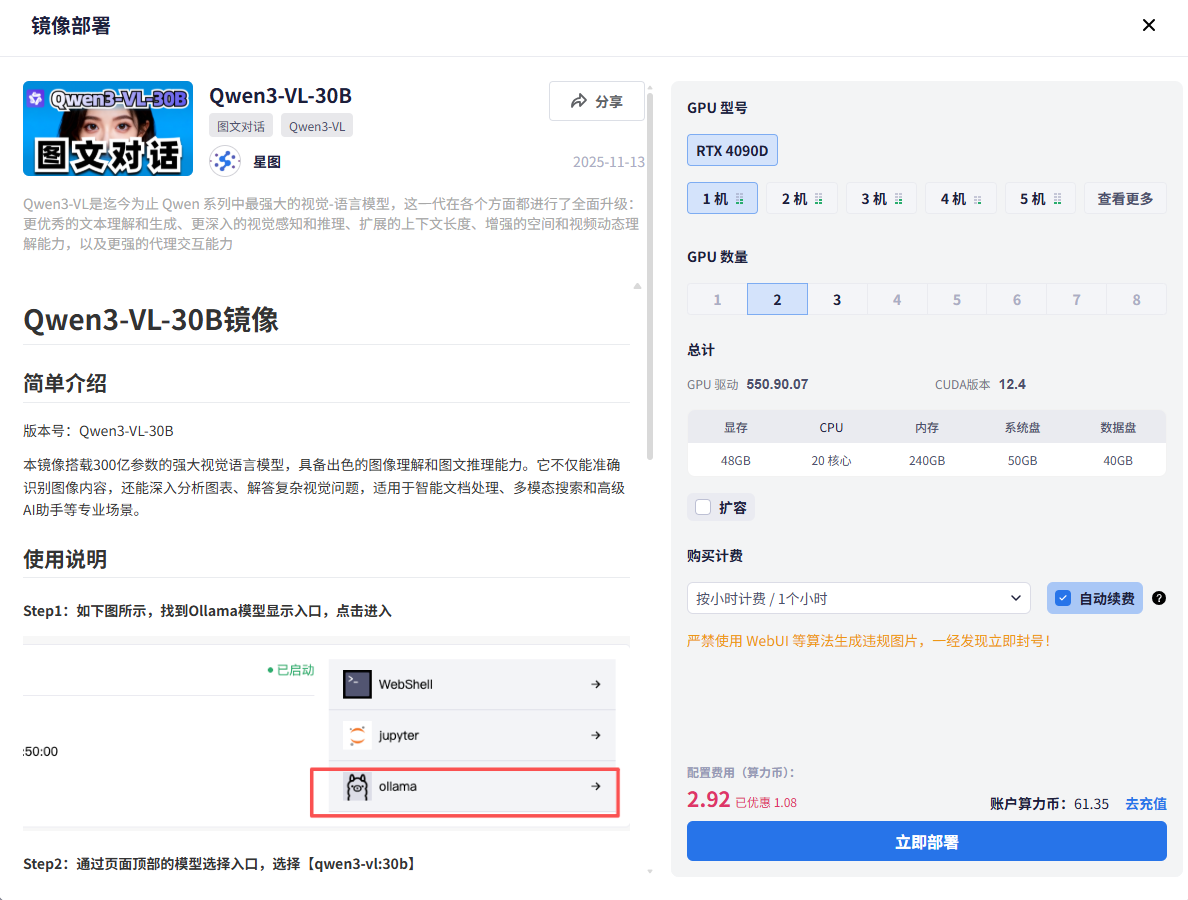
- 点击创建,等待几分钟,实例就会启动完成。
2.2 测试模型基础功能
实例启动后,我们首先验证一下模型是否正常工作。
- 在实例的控制面板,你会找到一个名为 “Ollama 控制台” 的快捷访问链接。点击它。
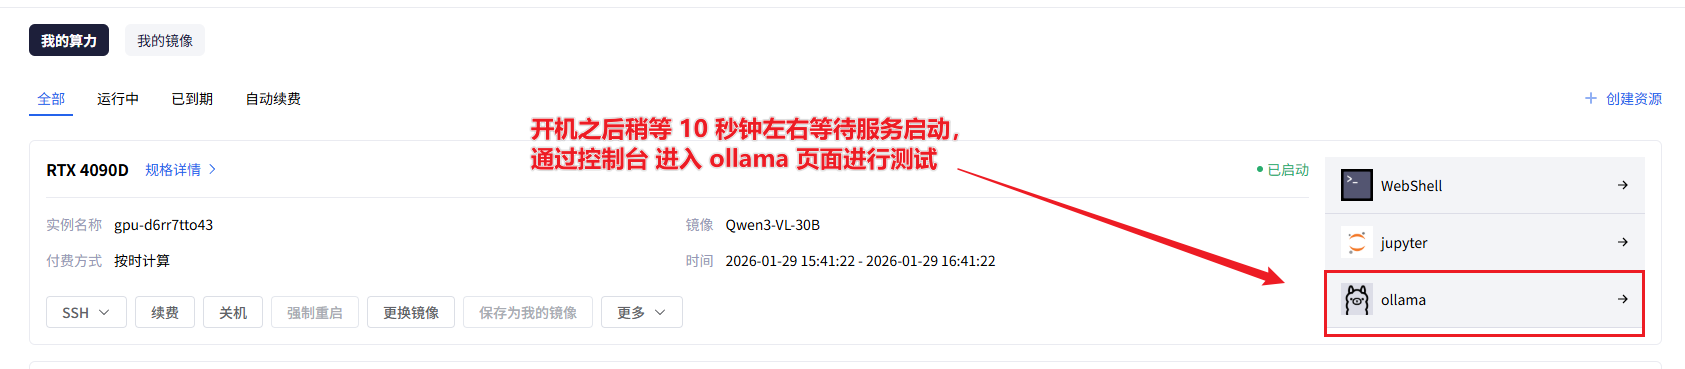
- 这会打开一个Web界面,在这里你可以直接和Qwen3-VL:30B进行图文对话。发送一条测试消息,比如“你好,请介绍下你自己”,看看它是否能正常回复。这能确保模型服务本身是健康的。
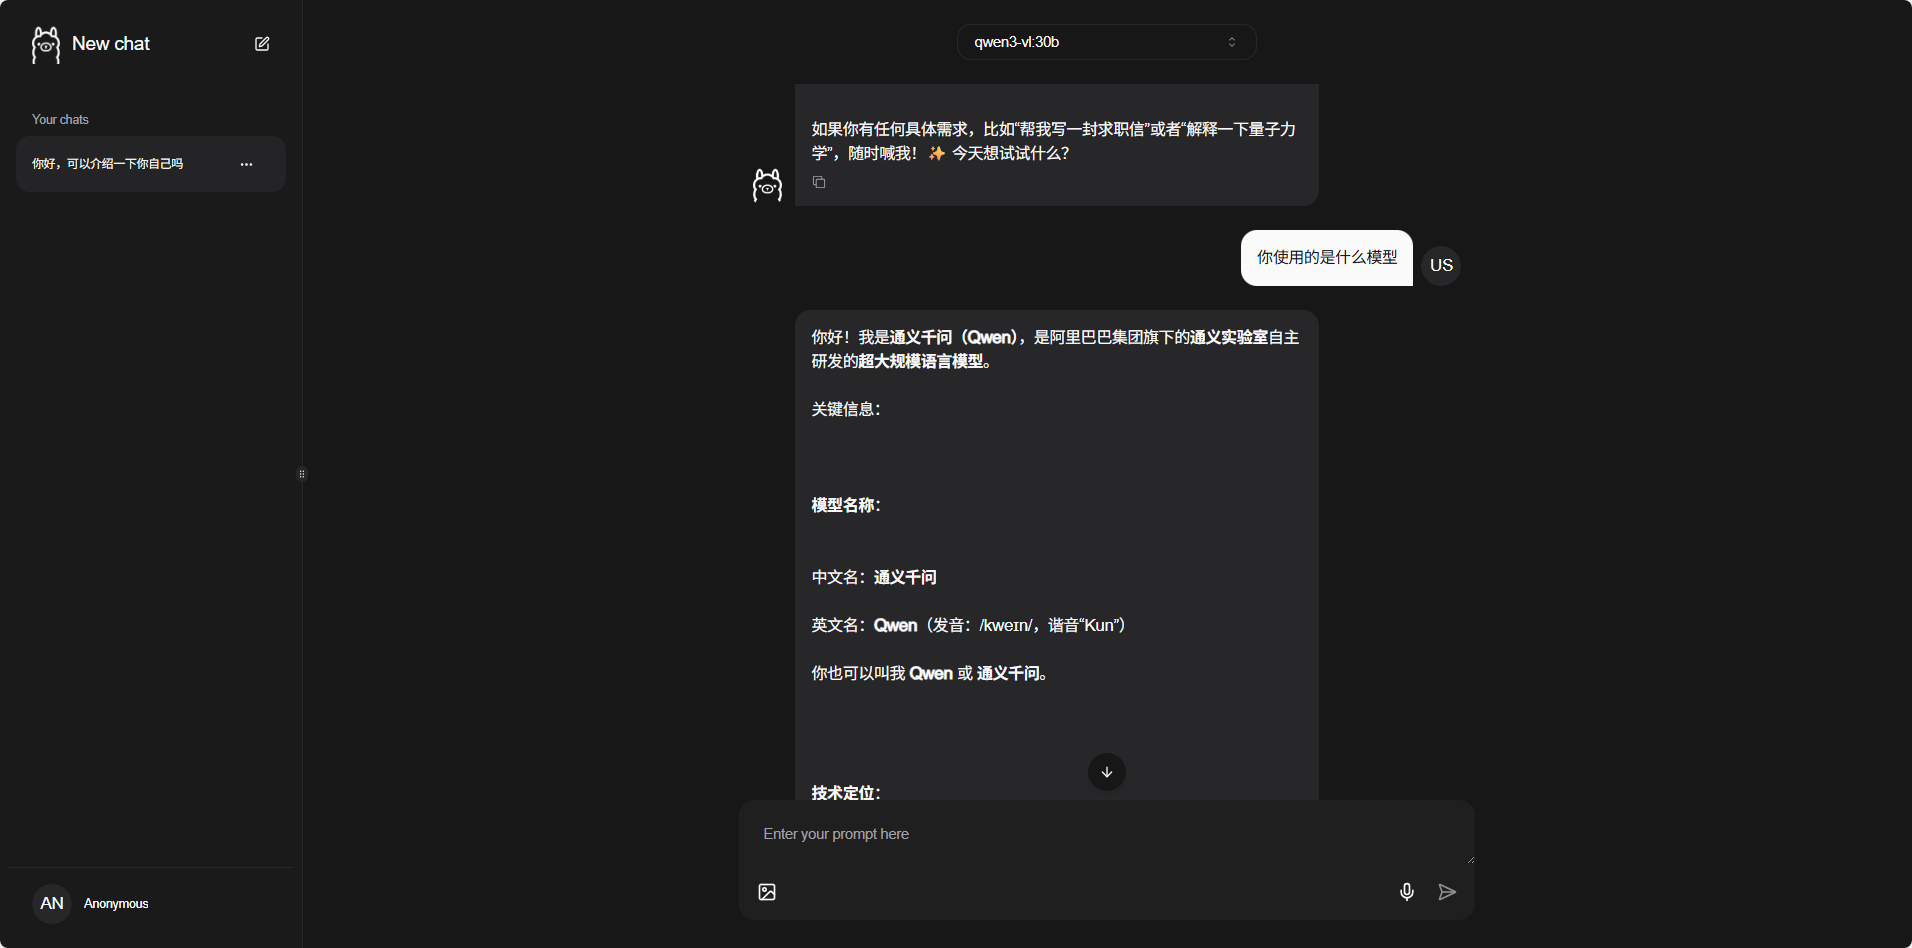
- (可选但推荐)API连通性测试:星图平台的实例会提供一个公网访问地址。我们可以在本地电脑上用一段简单的Python代码,测试是否能通过API远程调用到这个模型。这步验证了网络和API接口的畅通,为后面Clawdbot连接做准备。
运行这段代码,如果能看到模型的自我介绍,说明从外部网络也能成功访问了。from openai import OpenAI # 注意:base_url需要替换成你的实例实际公网地址 # 通常格式为:https://你的实例标识-11434.web.gpu.csdn.net/v1 client = OpenAI( base_url="https://gpu-pod697b0f1855ba5839425df6ea-11434.web.gpu.csdn.net/v1", api_key="ollama" # Ollama服务的默认API Key ) try: response = client.chat.completions.create( model="qwen3-vl:30b", messages=[{"role": "user", "content": "你好,你是谁?"}] ) print("API调用成功!回复内容:") print(response.choices[0].message.content) except Exception as e: print(f"连接失败,请检查: {e}")
至此,我们的“AI大脑”已经在线且运行良好。接下来,我们要安装“桥梁”Clawdbot。
3. 第二步:安装与配置Clawdbot
Clawdbot是我们机器人的控制框架,我们将通过它来管理和交互模型。
3.1 安装Clawdbot
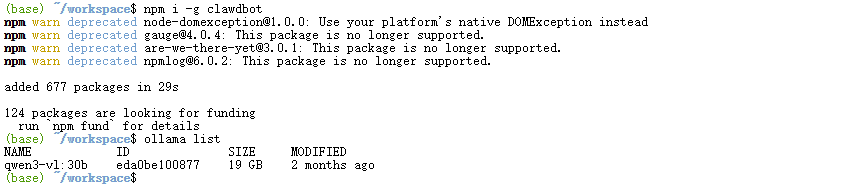
星图平台的系统环境通常已经配置好了Node.js和npm镜像。我们通过SSH连接到刚才创建的实例,执行一条命令即可完成安装:
npm i -g clawdbot
3.2 初始化配置
安装完成后,运行初始化向导。这个向导会交互式地引导你完成基础设置,对于初次接触的用户非常友好。
clawdbot onboard
运行命令后,你会看到一系列配置选项。作为上手教程,我们大部分选项可以先按回车选择默认值或暂时跳过,后续可以在Web控制面板里更直观地修改。关键步骤包括:
- 选择运行模式(选择
local本地模式)。 - 配置模型供应商(这里先跳过,我们后面手动配置)。
- 设置工作目录等。
向导完成后,Clawdbot的基础配置就生成了。
3.3 启动网关并访问控制台
Clawdbot的核心服务是一个网关(Gateway),它提供了Web管理界面。
- 启动网关服务:
clawdbot gateway - 获取控制台访问地址。Clawdbot默认监听
18789端口。你需要将实例原始访问地址的端口号(通常是8888)替换为18789。- 例如,你的实例访问地址是:
https://gpu-podXXXX-8888.web.gpu.csdn.net/ - 那么Clawdbot控制台地址就是:
https://gpu-podXXXX-18789.web.gpu.csdn.net/
- 例如,你的实例访问地址是:
- 在浏览器中打开上述地址。如果一切正常,你应该能看到Clawdbot的登录或概述页面。
4. 第三步:解决访问问题与安全配置
第一次访问控制台,你很可能会遇到页面空白或无法加载的情况。别担心,这是因为默认的安全配置限制了外部访问。
4.1 修改配置实现公网访问
问题的根源是Clawdbot默认只允许本地(127.0.0.1)访问。我们需要修改配置文件,让它允许公网访问,并配置一个安全令牌。
- 编辑Clawdbot的配置文件:
vim ~/.clawdbot/clawdbot.json - 找到
gateway配置部分,进行如下关键修改:"gateway": { "mode": "local", "bind": "lan", // 将原来的 "loopback" 改为 "lan",允许局域网/公网访问 "port": 18789, "auth": { "mode": "token", "token": "csdn" // 设置一个访问令牌,例如设为 csdn }, "trustedProxies": ["0.0.0.0/0"], // 信任所有代理,适用于云平台的反向代理 "controlUi": { "enabled": true, "allowInsecureAuth": true } }"bind": "lan":这是最关键的一步,让服务监听所有网络接口。"token": "csdn":设置一个密码,稍后登录控制台要用。"trustedProxies": ["0.0.0.0/0"]:允许任何来源的代理转发,适配云平台的网络环境。
- 保存并退出编辑器。然后重启Clawdbot网关服务(先按
Ctrl+C停止,再重新运行clawdbot gateway)。
4.2 登录控制面板
再次刷新浏览器中的控制台地址(https://你的实例地址-18789.web.gpu.csdn.net/)。 这次,系统会提示你输入令牌(Token)。输入刚才在配置文件中设置的 csdn,即可成功进入Clawdbot的Web控制面板。 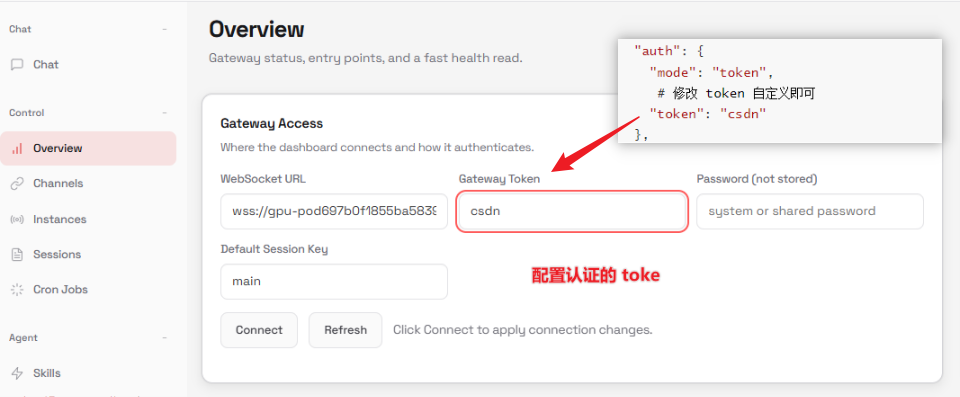
看到这个界面,说明Clawdbot的“控制中心”已经部署成功,可以从公网访问了。接下来,我们要把它的“大脑”换成我们自己的Qwen3-VL:30B。
5. 第四步:连接Clawdbot与Qwen3-VL:30B模型
现在,我们要告诉Clawdbot:“别用你自带的或者默认的模型了,去连接我们本地正在运行的、更强大的Qwen3-VL:30B。”
5.1 配置自定义模型供应商
我们需要再次编辑 ~/.clawdbot/clawdbot.json 配置文件,在 models.providers 部分添加我们自己的Ollama服务作为模型供应商。
- 打开配置文件:
vim ~/.clawdbot/clawdbot.json - 找到
"models": { "providers": { ... } }这部分。在里面添加一个新的供应商,命名为my-ollama:"models": { "providers": { "my-ollama": { // 新增的自定义供应商 "baseUrl": "http://127.0.0.1:11434/v1", // Ollama服务的本地API地址 "apiKey": "ollama", // Ollama的默认API Key "api": "openai-completions", // 使用OpenAI兼容的API格式 "models": [ { "id": "qwen3-vl:30b", // 模型ID,必须和Ollama中的名称一致 "name": "Local Qwen3 30B", // 在Clawdbot中显示的名称 "contextWindow": 32000 // 模型的上下文长度 } ] }, // ... 这里可能还有其他已有的供应商配置 } }baseUrl:指向本地Ollama服务的API地址(11434是Ollama默认端口)。apiKey:Ollama的默认认证密钥就是ollama。id:必须填写qwen3-vl:30b,这是我们在Ollama中拉取和运行的模型名。
5.2 设置默认使用的模型
添加了供应商后,我们还需要告诉Clawdbot,默认使用这个供应商下的哪个模型。找到配置文件的 agents 部分:
"agents": {
  "defaults": {
    "model": {
      "primary": "my-ollama/qwen3-vl:30b" // 将默认模型指向我们刚定义的
    }
  }
}
将 primary 模型设置为 my-ollama/qwen3-vl:30b。这个格式是 供应商名/模型ID。
5.3 重启服务并验证
- 保存并关闭配置文件。
- 同样,需要重启Clawdbot网关服务以使配置生效(
Ctrl+C然后重新运行clawdbot gateway)。 - 验证连接:打开一个新的终端窗口,连接到你的实例,运行以下命令实时查看GPU状态:
watch nvidia-smi - 回到Clawdbot的Web控制台,导航到 Chat 页面。尝试发送一条消息,比如“画一只在星空下奔跑的猫”。
- 观察
watch nvidia-smi那个终端窗口。当你发送消息后,如果看到GPU的显存使用率(GPU-Util)和已用显存(Memory-Usage)有明显的上升波动,就像下图所示,那么恭喜你!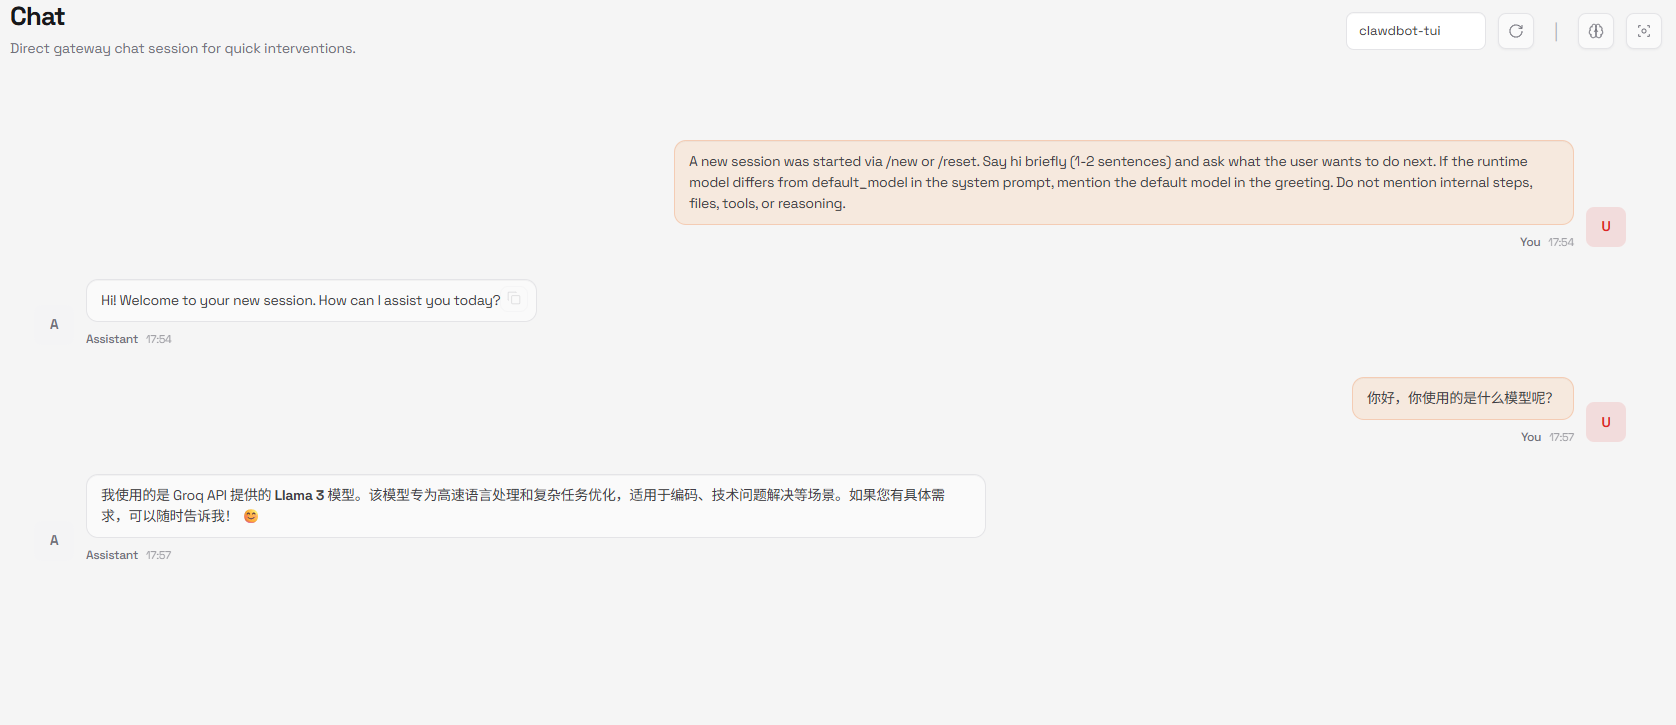 这证明Clawdbot已经成功调用了本地的Qwen3-VL:30B模型进行推理计算。你在Chat页面收到的回复,正是来自这个300亿参数的强大模型。
6. 总结
到这里,我们已经完成了整个搭建流程中最核心、最具技术挑战的部分。让我们回顾一下成果:
- 环境就绪:我们在CSDN星图AI云平台上,一键部署了预装Qwen3-VL:30B和Ollama的高性能GPU实例。
- 模型验证:通过Ollama Web界面和本地API测试,确认了多模态大模型服务运行正常。
- 框架搭建:安装并配置了Clawdbot机器人框架,解决了公网访问问题,成功进入了Web控制面板。
- 核心集成:通过修改配置文件,将Clawdbot的AI能力后端从默认模型切换为我们私有的、本地部署的Qwen3-VL:30B,并在Chat页面完成了最终对话测试。
现在,你已经拥有了一个完全私有化、自主可控的AI助手后端。它不仅能处理文字,还能理解你上传的图片,并通过一个漂亮的Web界面与你交互。
下一步是什么? 在即将推出的下篇教程中,我们将把这个已经调试好的“AI大脑”正式接入飞书。你会学到如何创建飞书机器人、配置事件订阅和消息回调,最终实现在飞书群聊或私聊中,@你的机器人并发送图片/文字,就能获得Qwen3-VL:30B生成的智能回复。
从私有化部署到飞书集成,一个真正强大、可用的智能办公助手即将完整诞生。敬请期待!
获取更多AI镜像
想探索更多AI镜像和应用场景?访问 CSDN星图镜像广场,提供丰富的预置镜像,覆盖大模型推理、图像生成、视频生成、模型微调等多个领域,支持一键部署。

聚焦RDK与具身智能,汇集机器人开发教程、开源案例和技术交流
更多推荐
 24
 0
- 0


 已为社区贡献24条内容

所有评论(0)